Aller au contenu principal
← Tous les projets
En construction
AI infrastructure · CRM
Built inside IntiGo
2026

Argus

Le cerveau de l’entreprise — un système d’opérateur IA toujours actif, ancré dans les données de production et supervisé par des humains.

Je suis développeur chez IntiGo, une entreprise de logistique de taille moyenne : ~100 véhicules, 275 chauffeurs, des centaines de marchands qui expédient des colis chez nous chaque jour. Argus est le système d’opérateur IA que je construis pour faire tourner l’entreprise comme un CEO utilise du personnel spécialisé — sauf que le personnel, ce sont des agents IA ancrés dans notre base de données de production réelle, et l’humain qui les supervise, c’est moi.

Écrit par , ingénieur full-stack senior à Tunis. LinkedIn · GitHub

Claude API (Anthropic)OpenAI APIGemma 4 (local · Mac mini)Qwen2.5:14b (local · Ollama)LLM ApplicationsAgentic AIAI AgentsLLM AgentsMCPTool CallingFunction CallingPrompt EngineeringContext EngineeringStructured OutputsMemory SystemsHuman-in-the-LoopRAGVector SearchEmbeddingsLLM EvalsAI WorkflowsAI AutomationModel Routingn8nNode.js / TypeScriptPostgreSQL (read-only replica)GitHub ActionsSlack APIMeta APIMac mini · on-prem

“Et si l’entreprise elle-même avait un esprit ?”

L’idée, en un paragraphe

Un réseau d’agents IA spécialisés — chacun excellent dans une seule tâche — connectés par un backbone partagé, tous lisant la même réplique en lecture seule de la base de production, tous traçant chaque décision qu’ils prennent. Claude est le décideur. Les agents traitent le travail routinier de façon autonome. Tout ce qui est ambigu, sensible ou à fort enjeu remonte à un humain via Slack et email.

Avec le temps, le système gagne de l’autonomie sur les catégories où son bilan est propre et reste prudent sur les autres. Moins un assistant IA, plus une main-d’œuvre IA qui fait tourner l’entreprise pendant que tout le monde dort, et présente les preuves chaque matin.

Pourquoi c’est possible maintenant, et pas il y a deux ans

Trois choses ont changé. D’abord, les modèles sont devenus assez bons — Claude peut lire un email, retrouver une commande en base et écrire une réponse meilleure que ce que la plupart des employés produiraient sous pression. Ce n’était pas vrai en 2023.

Ensuite, la plomberie est devenue bon marché. n8n, Postgres, un Mac mini sous un bureau, l’API Claude — toute la stack coûte moins qu’un salaire mid-level par an.

Enfin, le problème du grounding est résolvable. C’est celui dont personne ne parle assez.

Le principe du grounding — l’agent n’invente jamais un fait

La plupart des produits « employé IA » que j’ai vus tricheront sur la partie la plus difficile. Ils ingèrent vos documents, font un peu de magie RAG, et espèrent que le modèle dira quelque chose de sensé. Ça ne marche pas en opérations.

Si un client demande « où est mon colis ? » et que l’IA invente un numéro de suivi, l’entreprise perd le client. Si elle annonce un mauvais prix, l’entreprise perd de l’argent. Si elle s’engage sur une date de livraison qui n’existe pas, l’entreprise perd la confiance — et la confiance, en logistique, c’est le vrai produit.

Avant de composer toute réponse client, l’agent doit appeler un outil de lecture sur la base de production. La réponse est construite à partir de ce qui revient. Si la lookup ne renvoie rien — commande inconnue, client introuvable, enregistrement manquant — l’agent ne devine pas. Il rédige un brouillon et fait remonter. Plomberie ingrate. Et tout le jeu se joue là.

Module 1 — Agent de triage email

Surveille la boîte mail de l’entreprise en quasi temps réel. Pour chaque email entrant, Claude le lit et choisit une action parmi quatre : ne rien faire (newsletters, reçus, notifications automatiques), répondre (rédiger une réponse), notifier (alerter un humain sur Slack et par email parce que quelqu’un doit agir), ou escalader (l’agent n’est pas sûr — on remonte).

Chaque décision est tracée. Chaque latence mesurée. Chaque token compté. La règle non négociable : l’envoi automatique est désactivé au lancement. Chaque réponse est un brouillon qu’un humain valide, jusqu’à ce que le taux d’override prouve que l’agent est sûr sur une catégorie donnée. À ce moment-là, et seulement là, il gagne le droit d’envoyer seul.

Module 2 — Opérateur réseaux sociaux

Même architecture, appliquée d’abord à Facebook (Instagram et WhatsApp ensuite — ils partagent l’API Meta). Répond aux commentaires. Répond aux DMs Messenger. Publie depuis un calendrier validé par un humain.

Chaque réponse est ancrée dans des données réelles. Un client commente « où est mon colis ? » — l’agent recherche l’expédition réelle et répond avec le statut réel. Le client demande un devis — l’agent va chercher le vrai tarif. Le client parle de remboursement — l’agent n’y touche pas ; il rédige un brouillon pour revue humaine.

Les canaux publics, ce sont des erreurs publiques. La barre d’autonomie démarre donc plus haute qu’en email. Seuls les intents les plus sûrs et les plus répétitifs répondent en auto. Tout ce qui est émotionnel, juridique, en forme de plainte ou inconnu part en brouillon pour revue.

Module 3 — Annuaire membres & moteur de conversation outbound

Les deux premiers modules écoutaient. Le module 3 parle — à grande échelle. Une couche annuaire au-dessus de la base intigo_finance permet au LLM de retrouver la bonne personne parmi des milliers de membres (1 000+ chauffeurs, marchands et partenaires), d’ouvrir une conversation bidirectionnelle sur le bon canal (email, WhatsApp, SMS), et d’ancrer chaque message sortant dans des données opérationnelles réelles : « où est le colis COL-4821 que tu transportes ? » est construit à partir d’une lookup live, pas d’une supposition.

Quand le destinataire répond, l’agent lit la réponse dans le même contexte ancré et décide de l’étape suivante — boucler le sujet, rédiger une relance, ou déclencher une action. Toute action à conséquence réelle repasse par le portail de confiance existant d’Argus : brouillon pour validation humaine d’abord, envoi autonome uniquement quand le taux d’override prouve que l’agent est sûr sur cette catégorie.

Module 4 — CRM interne, opéré en local

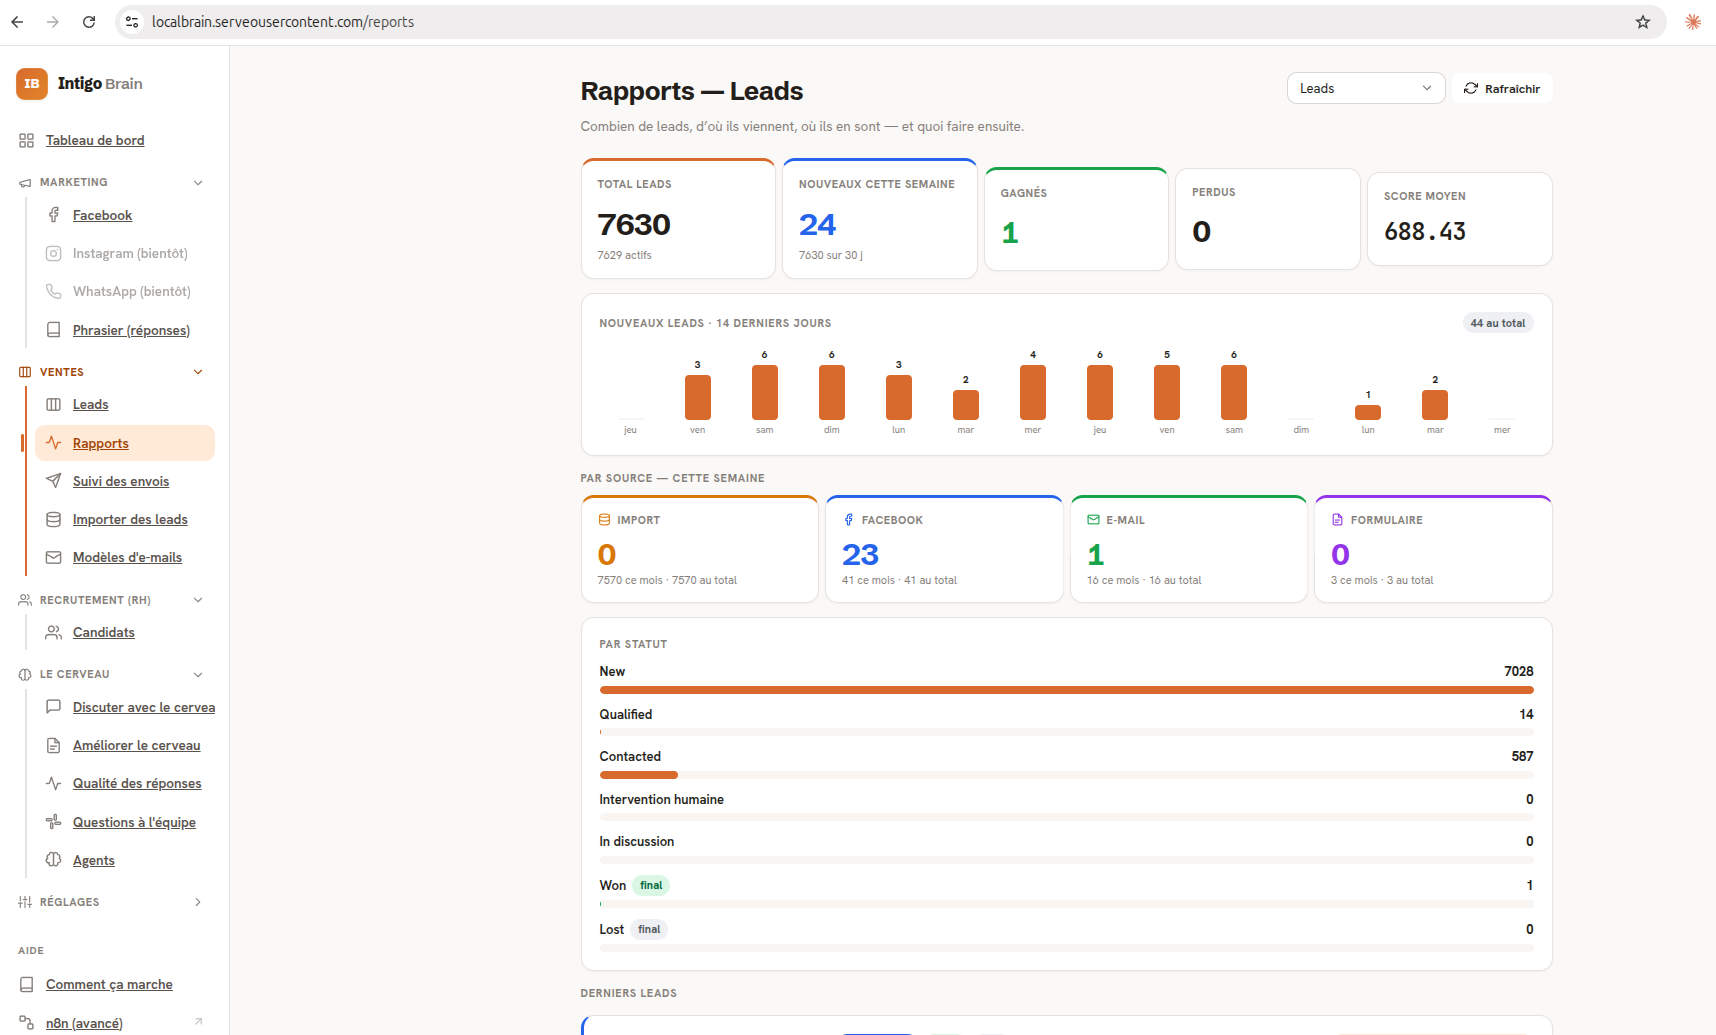
Argus a aussi besoin d’un cockpit interne, pas seulement de canaux sortants. Le module 4, c’est la couche CRM au-dessus du cerveau : leads, pipelines commerciaux (Nouveau → Qualifié → RDV programmé → Proposition envoyée → Gagné/Perdu), automations marketing, RH — et, plus tard, support. Même règle d’ancrage : chaque action — assigner un lead, envoyer une séquence email, faire avancer une étape, programmer une relance — est construite à partir d’une lecture live de intigo_finance, et toute action à conséquence repasse par le portail de confiance existant d’Argus.

La couche de décision tourne ici sur un Gemma 4 local, hébergé sur un Mac mini sous le bureau, pas dans le cloud, pour trois raisons : les workloads sont assez routiniers pour que Gemma soit largement suffisant ; les données RH et leads sont sensibles et ne quittent pas le bâtiment ; et au volume d’IntiGo, l’inférence locale coûte €0 par appel. Claude (cloud) et Gemma (local) se répartissent par charge — Claude pour le raisonnement difficile et les réponses face client, Gemma pour le travail CRM routinier à fort volume et tout ce qui est sensible côté données.

L’architecture

Une stack hybride, parce que personne n’a résolu ça avec un seul outil. n8n des deux côtés — pour faire entrer le monde (webhooks, bases de données, APIs, email, schedules) et pour pousser les décisions (réponses, alertes, écritures en base, appels d’API, publications). L’IA au milieu, c’est le cerveau qui décide quoi faire.

Un service Node.js / TypeScript gère la logique de décision — les appels Claude, les garde-fous, les écritures en base. Postgres est la couche de vérité : chaque événement, chaque décision, chaque action, chaque métrique. Audit trail et source du dashboard au même endroit.

MCP comme protocole de backbone, pour qu’on puisse ajouter de nouveaux outils sans réécrire les agents. Tout sous GitHub, pour que le système soit portable : développement sur PC, prod sur Mac mini, secrets hors du repo, et l’ensemble se reconstruit en vingt minutes sur n’importe quelle machine.

Le trou du marché

Les frameworks d’orchestration d’agents (LangGraph, CrewAI, AutoGen) sont flexibles — tu construis tout toi-même. Les SaaS « employé IA » (Lindy, Relevance AI, Cognosys) sont préfabriqués et génériques — ils ne peuvent pas s’ancrer dans le schéma Postgres d’une entreprise spécifique. Les agents IA verticaux (Decagon, Sierra, 11x) sont excellents sur une tâche — pas un cerveau d’entreprise.

Les plateformes de knowledge enterprise (Glean, Hebbia, Sana) sont surtout de la recherche et du résumé sur des documents. Palantir Foundry est le cerveau opérationnel originel — produit ancien, à un milliard de dollars, pas fait pour les PME.

Il semble y avoir un trou au milieu pour l’opérateur IA opinion-né, dédié à une seule entreprise. Argus est le pari que ce trou est réel — et qu’une entreprise opérationnelle de taille moyenne peut être son propre cerveau.
Architecture en profondeur

Pas un pipeline — une équipe événementielle.

Argus n'est pas un flowchart fixe. C'est une équipe d'agents spécialistes qui réagissent à des événements sur un bus partagé : un connecteur fait entrer quelque chose (un email, un changement DB, un formulaire, un schedule) et émet un événement. Le bon expert se réveille, s'ancre dans intigo_finance, agit — et son action émet un nouvel événement, qui réveille le suivant. La boucle continue jusqu'à un état terminal.

Les cinq couches & la boucle

Cinq couches : connecteurs en entrée, bus d'événements, l'équipe (orchestrateur, expert, portail de confiance, hand-off), canaux en sortie, vérité & audit. La boucle est le cœur : l'action d'un canal émet un nouvel événement, qui réveille l'expert suivant.

Une trace de bout en bout

« Où est le colis COL-4821 ? » — émis, routé, ancré, validé par le portail de confiance, envoyé, puis ré-entré comme nouvel événement à la réponse du client. Aucun expert n'appelle un autre directement — chacun émet, le suivant se réveille.

L’équipe en pratique — experts & outils

Chaque expert est une ligne de config : un rôle, un prompt, une liste d'événements auxquels il souscrit, une liste d'outils, et un portail de confiance propre. Ajouter un spécialiste = ajouter une ligne. Voici cinq exemples, tels qu'ils existeraient dans la table.

Expert Suivi de colis

Auto

Répond aux questions « où est mon colis ? » sur tous les canaux entrants, avec le statut réel lu en base.

Souscrit à
email_receivedmessage_receivedcomment_received
Outils
track_shipmentestimate_etalast_known_location

Expert Leads

Brouillon

Reçoit un lead, déduplique contre l'annuaire, scorale et crée la carte dans le pipeline (Module 5).

Souscrit à
lead_createdform_submitted
Outils
dedupe_directoryscore_leadcreate_pipeline_cardassign_owner

Expert Remboursements

Escalade

Reconnaît une demande de remboursement, rassemble la commande et le paiement, et fait remonter à l'humain — jamais d'envoi auto.

Souscrit à
refund_requestedcomplaint_detected
Outils
lookup_orderlookup_paymentcheck_refund_policybuild_handoff_brief

Expert Questions DB

Auto

Pour les questions de données venant des équipes internes sur Slack — purement lecture, jamais d'écriture, jamais face client.

Souscrit à
data_questionslack_mention
Outils
query_ordersaggregate_cod_by_zonetop_clients_by_volumedriver_workload

Expert Notifications

Auto

Ne décide pas le quoi — décide le qui et le où. Route chaque alerte vers le bon membre sur le bon canal (Module 3).

Souscrit à
reply_draftedstage_changedalert_needed
Outils
resolve_memberpick_channelsend_slacksend_email

Orchestrateur

Méta-agent

L'agent qui choisit les autres agents. Pour chaque événement, filtre les experts éligibles, présente une short-list au LLM, et passe la main à l'élu.

Souscrit à
*.new
Outils
filter_candidatesrank_short_listhandoff_to_expert
Améliorer le système — additif, jamais de re-câblage
Ce que tu veux…Ce que tu ajoutesCoucheDéploiement code ?
Une nouvelle source d’entréesun connecteur (n8n trigger)1config n8n
Une nouvelle façon de répondreun canal (n8n send + enum)4config n8n
Un nouveau type de spécialisteun expert (lignes de config)3Non — dashboard
Plus de capacité pour un spécialisteun outil (rows + join)3Handler si nouveau
Les invariants qui tiennent l’ensemble
  • Découplage par événements. Aucun expert n’en appelle un autre. Ajouter l’agent #30 ne touche pas aux agents #1–29.
  • Un seul contrat d’événement. Chaque connecteur normalise vers la même forme. Les experts sont aveugles à la provenance.
  • L’ancrage est obligatoire. Tout expert qui touche à un fait lit intigo_finance d’abord. Pas d’invention.
  • Le LLM ne voit qu’une short-list. Filtrer → short-list → le LLM choisit. Coût et latence restent plats quand l’équipe grandit.
  • L’autonomie se gagne, par expert. Shadow → brouillon → auto-par-catégorie. La prudence suit le blast radius.
  • Un seul chemin audité. Humains et experts passent par les mêmes opérations loggées. Manuel et auto émettent le même événement.
  • Tout est une ligne. Événements, runs, interventions, appels d’outils, experts, outils, canaux — Postgres = audit + dashboard.
Les modules dans cette image
Module 1Triage email. Un connecteur Gmail (Couche 1) + le premier expert (Couche 3) : quatre tools de décision, journal complet, envoi auto désactivé au lancement.
Module 2Réseaux sociaux. Plus de connecteurs (Facebook) + canaux (réponse publique, DM) + ancrage + garde-fou de la fenêtre 24h.
Module 3Annuaire & outbound. Le moteur de conversation outbound + résolveur multi-canal + le pattern filter → short-list → LLM.
Module 4CRM interne. La couche cockpit — leads, pipelines, marketing, RH — propulsée par un Gemma 4 local pour les workloads routiniers et sensibles.
Prochains modulesBus + dispatcher (la Couche 2 explicite) et moteur d'orchestration d'experts (la Couche 3 généralisée) : tourner six modules en une seule équipe.
Journal de construction

Comment le design évolue.

Les articles publiés au fur et à mesure, et les fils communautaires où je mets le design à l'épreuve. Lire la suite est facultatif — c'est là si tu veux suivre comment ça se construit en vrai.

Articles publiés

I'm Building the Company's Brain (The Sales, Marketing, Ops & C-Suite). This Is My Next Project.

Le tir d'ouverture. La question — et si l'entreprise elle-même avait un esprit ? Le principe d'ancrage qui le distingue d'un chatbot (l'agent n'invente jamais un fait), le trou que je vois dans le marché entre frameworks flexibles et plateformes enterprise, et les deux premiers modules par lesquels je démarre.

Building Version 1 of the Company's Brain: The Design I'm Committing To

La V1 sur laquelle je m'engage : périmètre étroit, triage de la boîte mail et routage humain d'abord. Quatre tools contraints (ne rien faire, répondre, notifier, escalader). Avant de composer toute réponse qui touche un fait réel, l'agent va le chercher dans la base de production. LLM pluggable, base de données comme unique source de vérité, garde-fous intégrés dès le jour 1 — pas ajoutés après.

How Do You Make a Local AI Actually Know Your Company?

Le problème de la connaissance : comment une IA locale apprend-elle vraiment les procédures spécifiques à l'entreprise qui vivent dans la tête des gens et pas dans la base de données ? La réponse sur laquelle j'atterris : une base de connaissance dédiée pour les règles — séparée de la base de production — couplée à un accès live à la base de production pour les données. Et crucialement, rien d'autre dans tout ce système ne passe en prod sans validation humaine — la connaissance reste éditable, jamais périmée, jamais inventée.

Building the Company Brain — Part 4: Its First Job Is the Most Boring One We Have, and It Started

Partie 4 — La V1 est lancée. Le premier travail de l'agent est celui sans gloire, répétitif, dont personne ne voulait : la file d'emails entrants. D'abord en mode shadow (il observe et propose, un humain agit), puis en mode assistance (il agit sous validation en un clic), puis l'autonomie uniquement sur les chemins que le trust gate a validés. Le principe du « boring first » — gagner l'autonomie sur un travail où les erreurs sont réparables et les sorties auditables, avant de le laisser toucher quoi que ce soit qui compte.

Revue communautaire
Redditr/GrowthHacking

Posté le design V1 sur r/GrowthHacking pour le mettre à l'épreuve — demander à la communauté ce qui pourrait mal tourner, ce qui a déjà été fait, et ce qu'elle ferait autrement. Trois points concrets sont ressortis du fil, et sont maintenant en haut du backlog.

Trois points en cours de traitement
  1. L'autonomie se gagne, ne se présume pas. Chaque capacité démarre en mode shadow et ne passe à l'action qu'après preuve de sûreté sur des données réelles — l'envoi automatique est désactivé par défaut, pas activé. La prudence est conçue dans l'architecture, pas ajoutée après.
  2. Publier le design avant de le verrouiller. Mettre l'architecture v1 face à de vrais critiques a fait remonter trois failles plus vite que je n'aurais pu les défendre — vérité opérationnelle vs vérité communicable, réponses obsolètes, et boucle de retour ouverte — et les trois sont devenues des mécanismes concrets au lieu de phrases en l'air.
  3. Rendre la frontière de sûreté structurelle, pas un jugement. Une règle que le modèle « suit en général » n'est pas une garantie. Étiqueter chaque fait dans le code avant que le modèle ne le voie signifie qu'un fait toxique-mais-vrai ne peut structurellement pas atteindre un client — testable, auditable, fail-safe par défaut.
Lire le fil sur Reddit →
--:--:--·TUN